投资智能体要做版本化技能维护,而不是无限自我进化
一项新的 SEC 文件问答研究把智能体错误变成有范围、可回归测试的技能补丁。这比让系统自行改写规则更适合投资研究。

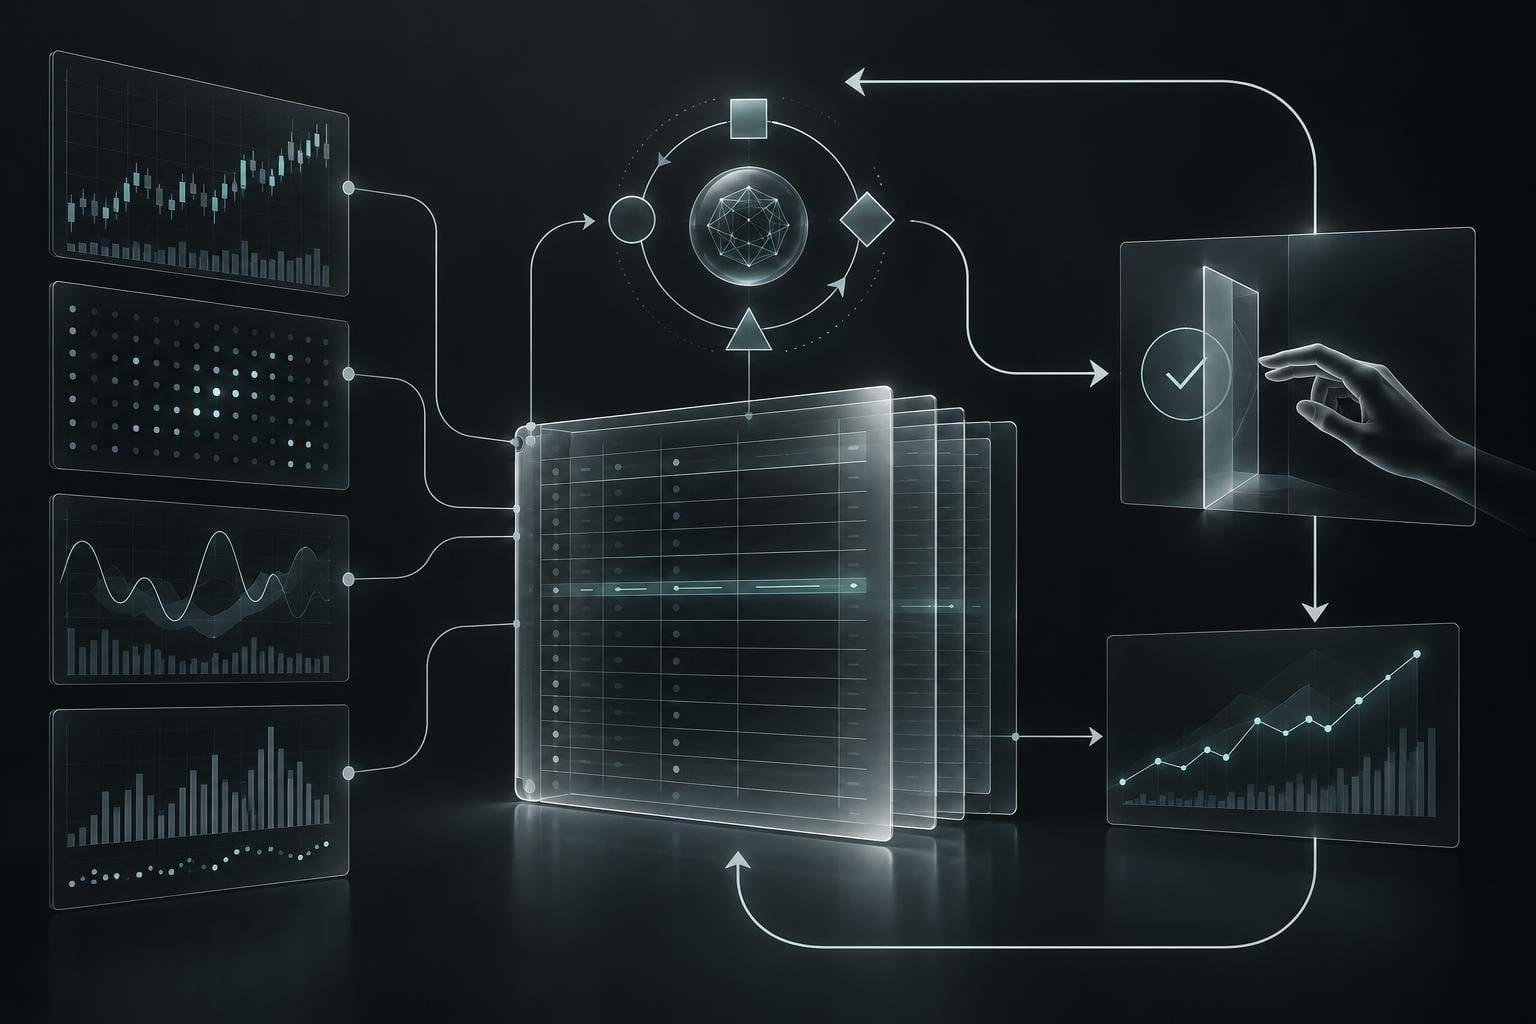
投资智能体真正需要回答的问题,不只是能否答对一份财报,而是它犯错之后能否改进,同时不悄悄破坏原本正确的答案。9 月 17 日发布的 FINSKILLOPS: A Self-Evolving Multi-Agent System for SEC Filing QA 提出了一个具体做法:把重复错误变成有明确范围的技能补丁,再经过定向验证、受保护案例回归测试、负控制和版本化的替换或退役,才允许上线(论文)。
我的判断是:这比“自我进化”这个口号更接近投资 AI 的前沿。研究工作的稀缺资产不是又一个流畅答案,而是一份可信的变更记录:系统学到了什么、变化适用于哪里,以及可能破坏了什么。
工作流从提示词变成维护
过去,错误答案常被当成提示词问题。分析师加一条指令,重新运行问题,然后希望它能泛化。新的做法把错误当成可分类的维护事件:报告期错了、主体错了、证据不足、算术错误,或把不兼容的单位混在了一起。诊断结果生成的是小型行为补丁,例如“提取增长率前先确认文件期末日”,而不是笼统地告诉模型“更仔细”。
这改变了投资研究自动化的基本单位。团队可以在模型和检索系统之外维护一份行为注册表。每条记录都有适用范围、触发它的案例、测试集、负责人、版本和退役规则。智能体可以提出补丁,但由受控流程决定是否进入生产。
这与财报筛选中的时间戳理由以及可审计的业绩电话会队列相连:只有当人能够还原事项为何出现、依据哪条来源时,输出才真正有用。
可投入研究流程的实现方式
一个财报研究助手可以用常见组件复现这一循环:记录每个被拒绝的答案,包括问题、主体、期间、检索段落、计算过程和模型版本;在提出修复前先分类错误;生成带有明确范围和反例的窄补丁;在触发案例、原本正确的保护集和相邻任务的负控制上测试;只有当证据链改善且回归风险可接受时才推广,否则修改、隔离或退役。
论文给出了一个值得注意但不能夸大的结果:在其运营研究中,33 个候选技能只有 6 个获准推广。这个拒绝比例恰恰是优点。它说明系统在区分“看起来合理的修正”和“可以安全上线的变更”。论文中的基准结果只能说明其设置下的证据,不能证明同一套注册表会改善所有投资流程。
SEC 公共文件很适合做这种测试,因为其中同时存在日期、主体、修订版、表格和脚注;但这也制造了陷阱。针对一家发行人特殊格式形成的补丁,可能只是语言过拟合。改善年报问答的规则,可能损害业绩公告问答。检索索引变化甚至会先改变证据集合,再影响所谓的“技能”评估。因此每个结果都应保留收据:源文件、页码或表格位置、访问时间、转换过程和答案。
60 分钟的研究-only 练习
选取三家公司共 20 份历史 SEC 文件,固定一个问题,例如识别某个业务分部披露的收入及其所属期间。不要交易、下单,也不要把结果当作建议。先让未修改的助手回答 20 个问题,记录精确答案率、证据支持答案率、无依据断言率和工具调用次数中位数,这就是基线。
然后挑出一种重复错误,写一条范围很窄的补丁,并在原有 20 题、10 道原先答对的保护题,以及 10 道补丁不应触发的负控制题上测试。观察 30–60 分钟。如果补丁无法引用相关文件段落,保护集准确率下降超过 10 个百分点,或系统开始对含糊文件给出自信答案,就停止。产出应是一张补丁卡和一张回归表,而不是预测或交易信号。
限制才是重点
这种流程不会消除模型风险。只记录显眼错误会产生选择偏差;把退役补丁从报告中删除会产生幸存者偏差;把“正确”定义成看似合理的文字而非核验过的数字和期间,会产生测量偏差。基准还可能奖励模型熟悉的格式。激励也有差异:供应商可能偏好较高的采纳率,而投资团队在错误修复代价很高时,应该更重视拒绝率。
因果关系同样薄弱。补丁后答案变好,可能只是题目更容易、文件更干净,或检索索引变化,而不是能力持久提升。财报格式和分析师问题会变化。安全系统应保留旧案例,为每次评估加时间戳,并定期重新检查假设。
对个人投资者,启示是要求证据收据和变更记录;对系统化团队,是像管理代码和数据一样管理研究行为;对构建者,则是把“自我改进”做成有闸门的维护管线,而不是允许智能体自行重写规则。前沿不是永不犯错的智能体,而是能够从错误中学习、又不隐藏学习代价的研究流程。
来源:FINSKILLOPS(arXiv:2609.19680);SEC EDGAR 公司文件。