投资研究接入人工智能前,先做一场披露审计
人工智能可以压缩披露文件的初筛时间,但真正可持续的流程,是让每个判断都留下可复核的证据账本。

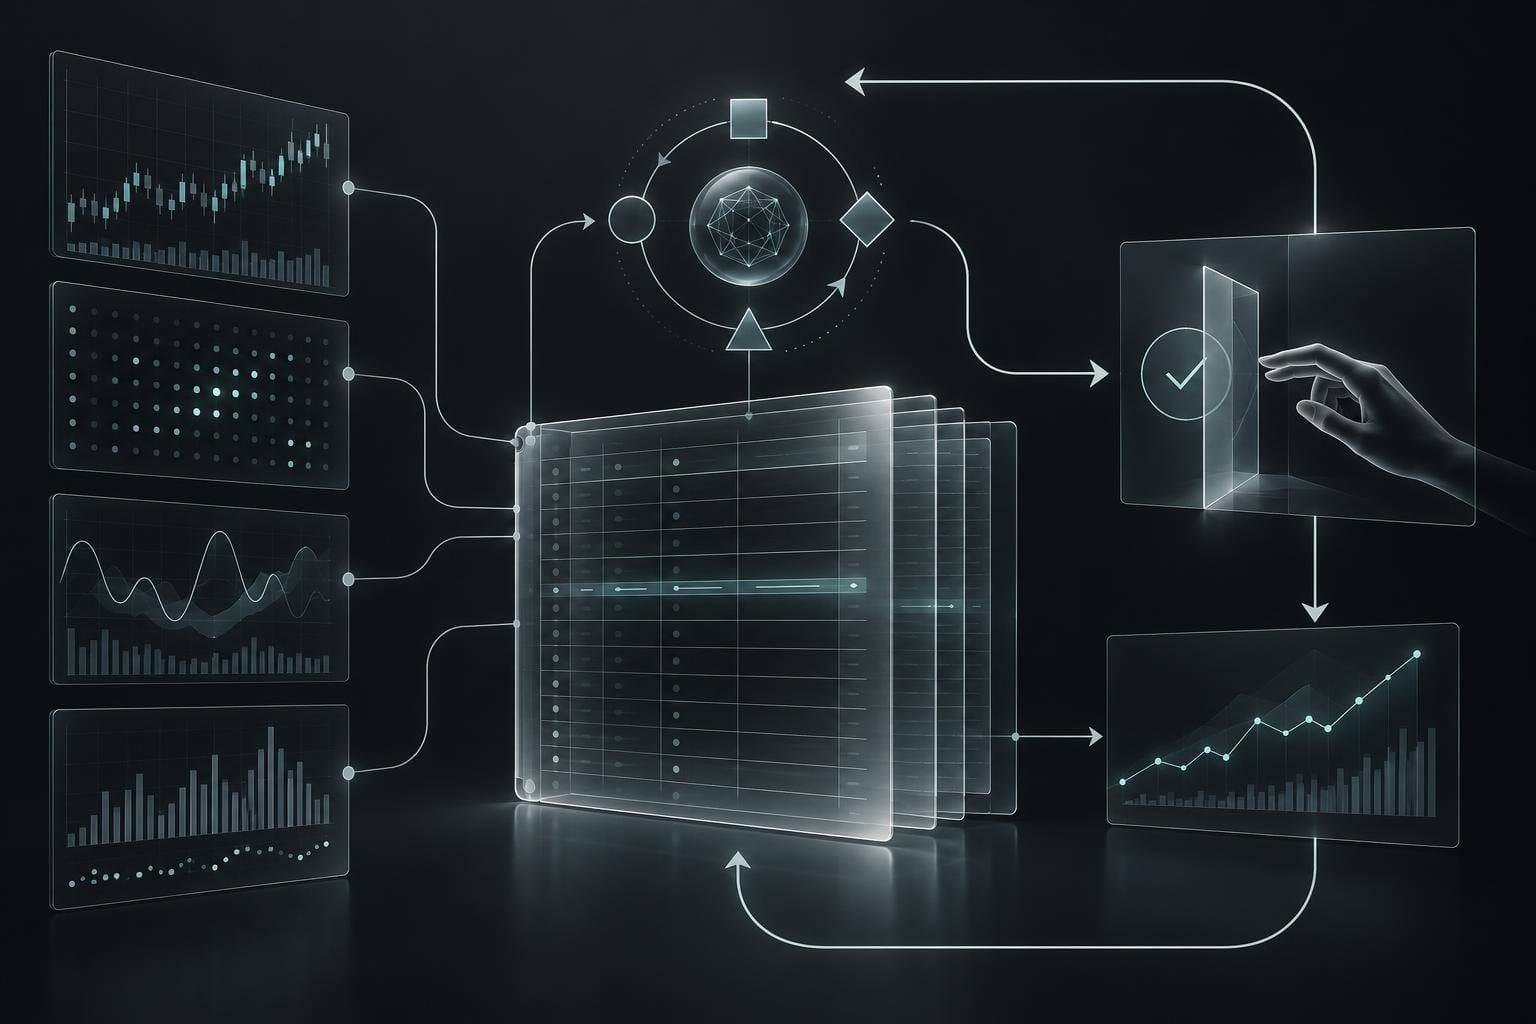
人工智能正在改变投资研究中一个不太耀眼、却很关键的环节:披露文件审阅。研究员可以让模型从申报文件或合规材料中提取变化、义务和未解决问题,先搭出一张研究地图。但地图更快生成,并不等于地图可靠。
更有价值的工作单位不是一份流畅的摘要,而是一场披露审计:每个重要断言都要有来源位置、日期、置信度,以及人工对“仍未核实”的明确标记。美国证券交易委员会近期讨论“人工智能时代的信息”时提醒,人工智能相关成本与责任可能在顾问、基金、中介机构之间转移,最终由投资者承担(SEC)。另一份 SEC 检查提示则强调,投资顾问需要定期检视合规政策是否充分、是否真正有效执行(SEC 风险提示)。合在一起,它们提出了一个流程问题:人工智能参与的审阅,能不能留下足够证据让别人挑战它?
从阅读文件到维护断言账本
过去的流程通常是线性的:打开文件,搜索关键词,标注段落,写成笔记,再传阅备忘录。现在可以把它拆成几个阶段。先锁定文件版本和元数据;再让模型按“变化、风险敞口、义务、假设、缺失数据、升级问题”提取候选断言;然后要求每一条都附上短引文或表格位置;最后由人工删除没有依据的内容,把其余项目标记为已确认、合理但待核实,或未解决。
这样一来,产物就变了。模型不是在判断一项发展对投资是否有利,而是在生成一列研究员可以逐条核验的事项。这和可审计的研究队列更接近,而不是一个自主分析师。
这种对来源的重视,也延伸了本系列关于可复现研究轨迹的讨论:人工智能参与的审阅,只有在别人能够从文件重新走到判断时,才真正有用。
它的实际价值不只是节省时间,而是把证据和解释分开。好的记录应包含稳定网址或文件哈希、获取时间、页码或章节、原始断言、模型改写、审阅者修正,以及下一步问题。结论变化时,团队才看得出究竟是证据变了、解释变了,还是模型换了一种说法。
模型能做什么,不能做什么
当输入范围受到控制时,人工智能擅长生成候选项、统一表述和比较两个期间的文本。它可以找出重复的风险措辞,把长篇叙述转成审阅队列。但它不擅长独立判断重要性、解决定义含混、发现文件没有说什么,也不一定能看出管理层措辞是否在回避问题。流畅的答案还可能掩盖来源错配:模型把不同期间拼在一起,把估计当成结果,或从相关性推断因果关系。
所以提示词必须允许它弃答。“没有找到支持段落”是合格结果;“判断依赖当前无法取得的附件”也是。审阅者还要抽查模型没有标出的内容,否则第一道筛选就产生选择偏差:流程衡量的是模型呈现了什么,而不是文件里实际存在什么。
一次 60 分钟的研究专用测试
选取一份公开披露文件,再选一份较早的可比文件。不要下单、调仓,也不要把结果当成投资建议。
基线: 先用通常方法人工审阅 30 分钟,记录找到的重大断言数量、后来核实的数量,以及形成一张简短证据表所需时间。
人工智能条件: 把同样两份文件交给模型,要求章节级引用并允许弃答,再用 30 分钟复核它的表格。测量引用精确率(抽查断言中有来源支持的比例)、人工补出的重大变化、修正次数、形成可审阅表格的时间,以及不同审阅者对重要性的意见一致度。
观察窗口限定为这一次测试,或延长至七天、重复测试七组可比文件。若模型不能提供稳定的来源位置,审阅者无法复现断言,或无依据断言超过预先设定的容忍度,就停止测试。目标是测量流程,不是预测收益。
不容忽视的边界
这项测试不能证明人工智能改善了投资结果。样本可能偏向格式整齐的文件;容易处理的材料更可能被留下,形成幸存者偏差。人工审阅者也可能偏爱简洁文风,带来测量偏差。模型供应商有动力强调覆盖率,投资团队则有动力强调效率。文件会修订,链接会失效,后来出现的重述也可能推翻当时看似合理的判断。
还有一条因果断层:可追溯性变好,可能改善审阅质量,但不等于资产配置变好。数据成本、延迟、保密要求、访问权限和合规控制,都可能超过所谓的生产率收益。账本能让错误判断更容易被追查,却不能让判断本身正确。
对主观投资者而言,持久的能力是逐条核验证据。系统化团队应把抽取质量和弃答表现作为持续监控指标。工具建设者则应把来源、版本和审阅者修正设计成正式输出,而不是可有可无的界面功能。前沿不是让人工智能听起来像分析师,而是让投资流程清楚显示:模型或人,究竟可能在哪里出错。