投资研究接入人工智能之前,先测试它的证据根基
人工智能可以让投资分析听起来可信,却不代表结论有证据根基。一个小型审计流程能把取证、语气与投资偏好分开测试。

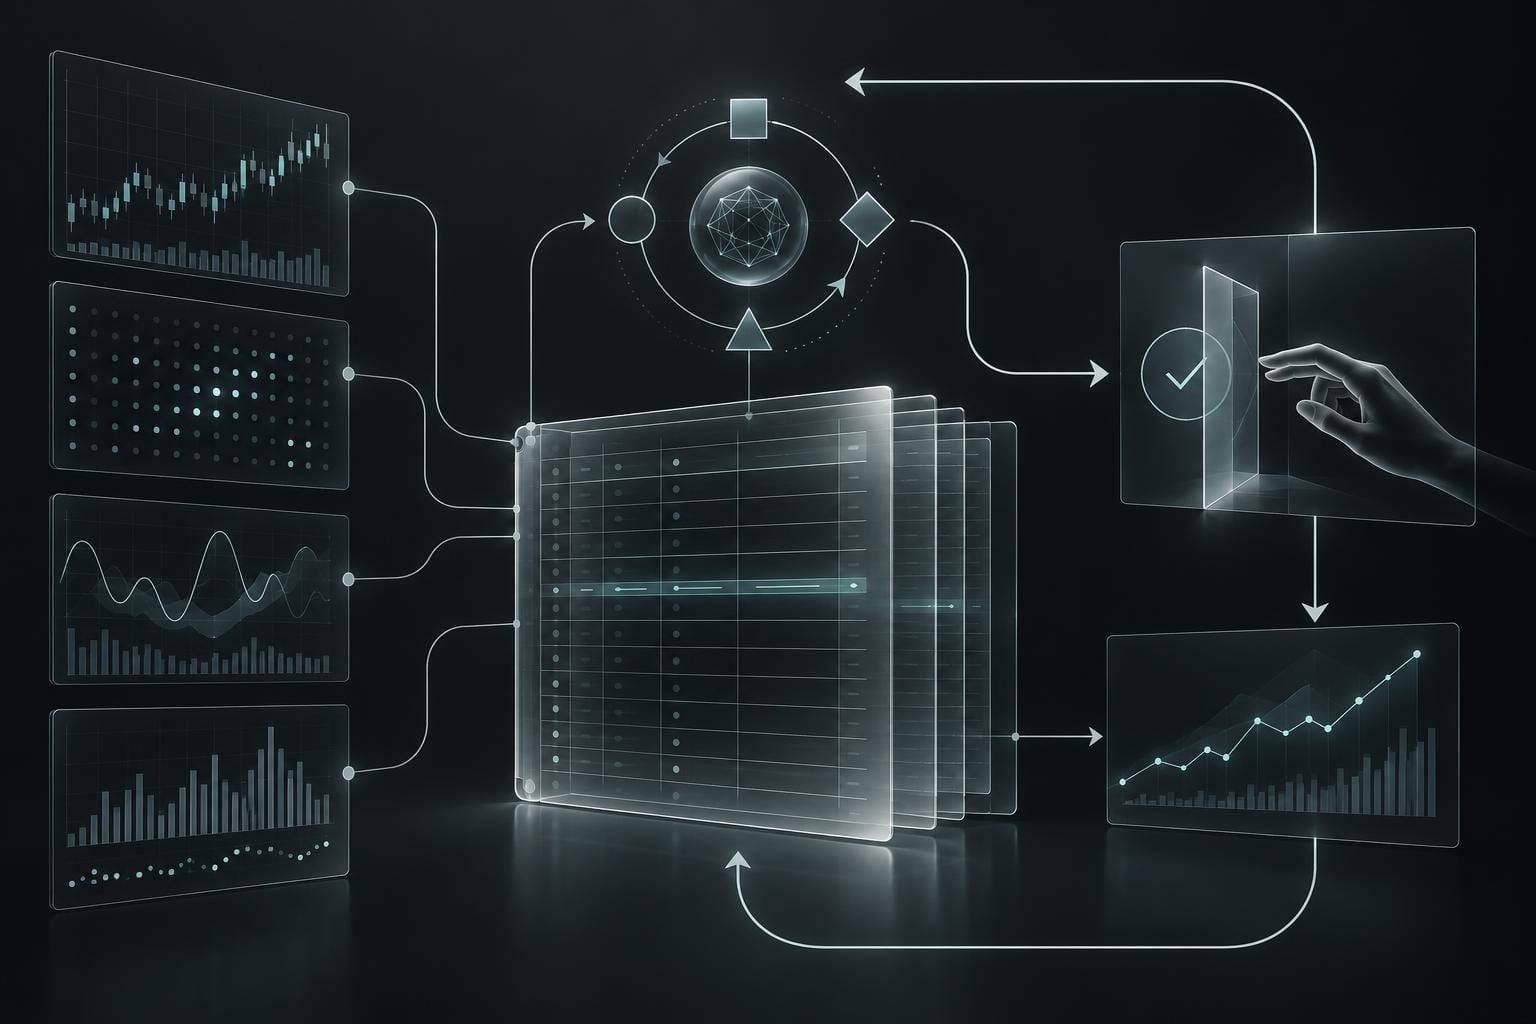
一份人工智能生成的投资建议,可能语气谨慎、引用看似合理,却没有真正站得住的证据。近期一项关于人工智能中介金融建议的研究提示,读者对建议的信任,不只受到内容影响,也受到表达方式和来源标签影响。对投资研究团队而言,这带来一个具体改变:在把模型放进研究流程前,要把“是否有证据支撑”和“是否像一位值得信任的顾问”分开测试。
旧流程往往是读完答案,再判断它是否有用。新的流程可以拆成两本账:第一本记录每个主张和对应原文;第二本记录答案如何表达不确定性、信心与投资者偏好。模型可以协助检索和比较,但人仍要判断主张是否被原文支持、是否及时、是否与问题相关。这是质量控制,不是交易路径。
研究循环发生了什么变化
Trustworthy FinAInce: Unpacking How AI-Mediated Financial Advice is Judged 讨论金融建议的判断方式,并区分建议风格与来源标签的作用。Artificial Intelligence in Equity and Crypto Markets 则把技术能力与盈利证据分开,覆盖研究、组合、执行和工具使用。两者都不能证明某个模型能提高收益,但共同支持一个更克制的工作结论:评估模型时,不能只看流畅度,还要看证据根基和决策质量。
实际操作时,先建立一个有日期的资料包,例如公司披露、业绩电话会文字稿、方法说明或监管文件。让模型提取主张,给出段落级引用,并明确标出证据缺口。随后保持资料不变,只更换回答角色:中性的研究助手、怀疑型审阅者、风险负责人。不要把最有说服力的回答评为最好。应检查引用是否真的支持主张、不确定性是否在改写中保留,以及加入偏好指令后事实层是否发生变化。
最终产物可以是一张六栏表:主张、原文段落、时间戳、不确定性、人工处理意见,以及主张属于描述、因果还是预测。比如“管理层说需求改善”是描述;“需求因定价而改善”是因果;“趋势会延续”则是预测。模型很容易在保持自信语气的同时,把这三类混在一起。
60 分钟研究练习
选一份公开且有日期的文件,先用人工写一份五句话摘要,作为基线。前 20 分钟从文件中建立十张主张卡片;接着 20 分钟让模型在只改变语气要求的情况下生成两份带引用摘要;最后 20 分钟由审阅者对照基线评分。
记录四项指标:有原文支持的主张比例、无支持主张数量、相互矛盾数量,以及不同语气下的信心变化。记录文件日期和模型版本。资料包用尽,或审阅者发现三条重大无支持主张时就停止。不要把结果转成证券建议或纸上交易。预期产物是一张审计表,说明模型是否扩大了取证覆盖,同时保持事实纪律。
可以把这项练习与智能交易的证据账本和机器学习期限结构研究流程对照。共同方法是保留输入、时间戳、转换步骤和人工判断,让后来者看清模型究竟贡献了什么。
限制本身也是结果
一份整洁的公开文件,比混合了表格、扫描 PDF 和相互冲突披露的资料包容易得多,因此练习存在选择偏差。引用是否蕴含主张,也不等于主张是否具有经济重要性;人工审阅者还可能偏爱熟悉的写法。若提示词变化太小,稳定性也会被高估。来源标签可能改变信任,却没有改变内容;而部署人工智能的组织激励,可能只报告速度,不报告升级处理和复核成本。
更重要的是,这个测试存在因果缺口。证据更扎实的建议或许能改善复核质量,但不能由此证明投资结果更好。市场状态会变化,信息有延迟,可信但错误的主张可能造成非线性损失。在失败模式尚未被真实资料与真实决策充分测量前,应把模型限制在检索、比较和提出质疑的层次。真正的前沿,不是让建议听起来更权威,而是让证据、不确定性和人工处置始终可审计。