先算清盈亏平衡点,再决定要不要用基础模型做预测
时间序列基础模型改变投资研究的地方,不是模型更大,而是研究者可以先用数据长度、季节性和小规模滚动测试决定是否值得投入。

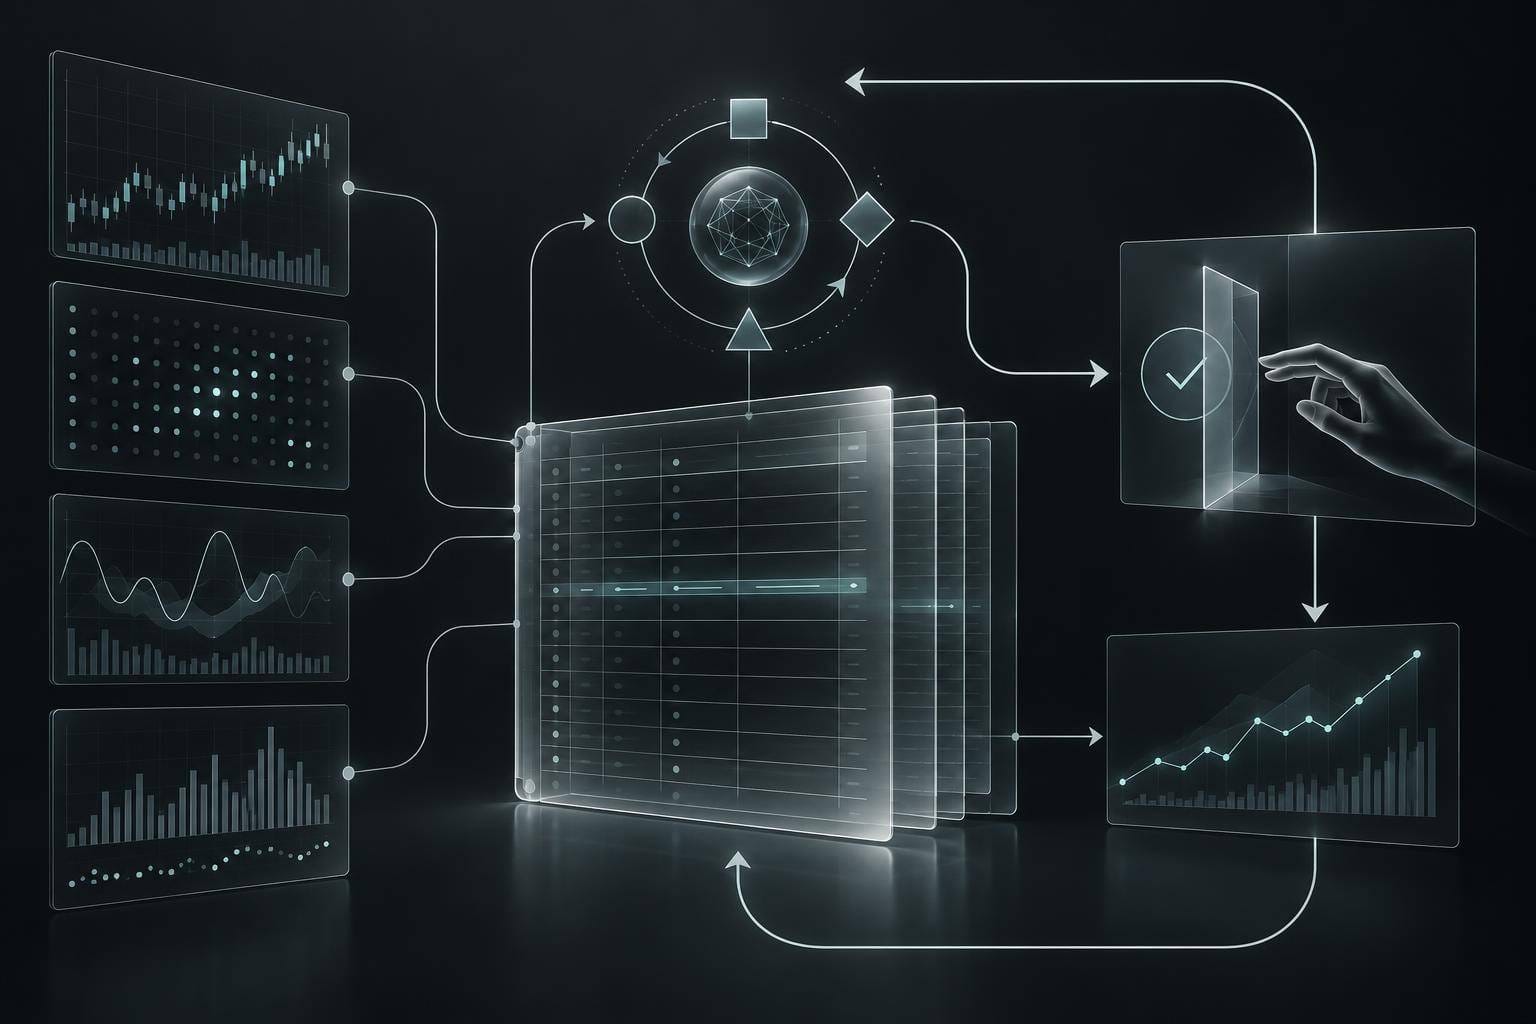
研究者面对时间序列基础模型时,最先该问的不是它是否比 XGBoost、ARIMA 或随机游走更先进,而是数据和决策是否值得承担额外的模型、基础设施与验证成本。最近的研究把投资研究流程推向一个更实际的方向:先设一道盈亏平衡门槛,再决定是否投入数周调试预测系统。
一篇 arXiv 研究在 30 个数据集上比较 Chronos、Moirai、Lag-Llama 等预训练模型与朴素模型、ETS、ARIMA 和 XGBoost,并改变训练样本规模。基础模型在 15 个数据集上胜出;在 6 个数据集上,经典方法从很小的样本开始就超过零样本基础模型,其余案例则存在依赖数据量的平衡点。另一篇研究考察五只流动性较高的美国股票,发现预训练模型的排名常常不错,但相对随机游走的改进很小且分散。这是研究证据,不是超额收益证明。
这对投资研究的实际改变是:研究者不再从“该部署哪一个模型”开始,而先回答三个较小的问题:有多少可用观测值?季节性是否真实存在?一次短的滚动验证是否足以改变选择?模型选择因此变成一种可以审计的研究时间分配。
新的研究队列
先固定带时间戳的数据定义:资产或股票池、频率、价格还是收益率目标、缺失值处理方式,以及信息截止时间。然后计算训练长度,做一个简单的季节性诊断。盈亏平衡研究在自己的基准中提出一条操作性规则:当训练样本少于 700 个且季节性明显时,可以先测试零样本基础模型而不微调。它应当被视为待验证假设,而不是普遍政策。
在打开模型排行榜之前,先写好基线。收益率类目标可以从随机游走开始,再加入一两个便宜而有力的替代方案,例如 ARIMA 或 XGBoost。所有模型必须使用相同预测期限、滚动起点和当时可获得的特征。金融收益率信噪比低、尾部厚、结构容易断裂,因此防止信息泄漏比模型名称更重要。
之后才加入时间序列基础模型,并记录推理成本、延迟、上下文长度、失败运行次数和每项预处理选择。离线损失指标更好,却需要不稳定的数据管道,不一定改善投资流程。若模型减少了开发时间,它可能有工程价值;但这仍不是可靠市场可预测性的证据。
最终输出应是一份四栏决策备忘录:基线误差、候选模型误差、不同滚动窗口下的不确定性,以及总研究成本。还要用通俗语言写出选择或淘汰候选模型的理由。可在相关处链接站内的金融收益率先验、部署诊断和智能交易证据账本,但不要把交易智能体的证据与预测能力混为一谈。
一个有边界的研究测试
用 60–90 分钟在一只流动性较高的资产或固定历史面板上做纸面研究。冻结数据截止时间,建立随机游走和一个简单监督式基线,再用一个零样本基础模型进行滚动起点预测。预先规定 MAE 或另一项预测损失;方向准确率只能作为次要描述指标,同时记录运行时间和候选模型击败基线的窗口比例。不要下单,也不要从结果推导预期收益。
基线是随机游走加简单模型;每个模型使用相同的历史评估窗口,不得随机打乱。如果数据定义改变、特征使用了预测时点尚不可得的信息,或候选模型无法在相同窗口上评估,就停止测试。最后写下候选模型是否改变研究决策以及原因。若另做七天纸上交易账本,它只能观察操作行为,不得投入资金,也不得声称模拟决策能预测实盘收益。
证据尚未解决什么
这些研究是基准实验,不是生产组合。五只股票和 30 个数据集不能证明模型在不同市场、制度、成本和期限下都稳健。模型排名可能受数据选择、幸存者偏差、测量方式和发表激励影响。若研究团队反复测试,只保留看起来漂亮的结果,短期试验本身也会污染盈亏平衡点。
预测误差下降与投资结果改善之间还有因果断层。成本、换手、容量、延迟、执行和风险约束都会介入。预训练数据还可能带来隐性的重叠或过时先验。基础设施选择也有激励问题:供应商和研究团队都可能有理由把更大的模型描述成必需品。
因此,结论应当克制但有用。AI 改变预测研究的地方,是让模型选择变得有条件、可复现,而且容易停止。前沿不是自动预测市场,而是一道有纪律的门槛:先证明基础模型值得公平比较;如果不能,简单基线本身就是更有信息量的结果。
English companion: Before Choosing a Forecasting Model, Measure the Break-Even Point。