别再切换 AI 模型,开始编排它们
多模型软件工程实用指南:通过清晰分工、受限交接、独立评审与确定性验证,降低 AI 开发的成本和返工。

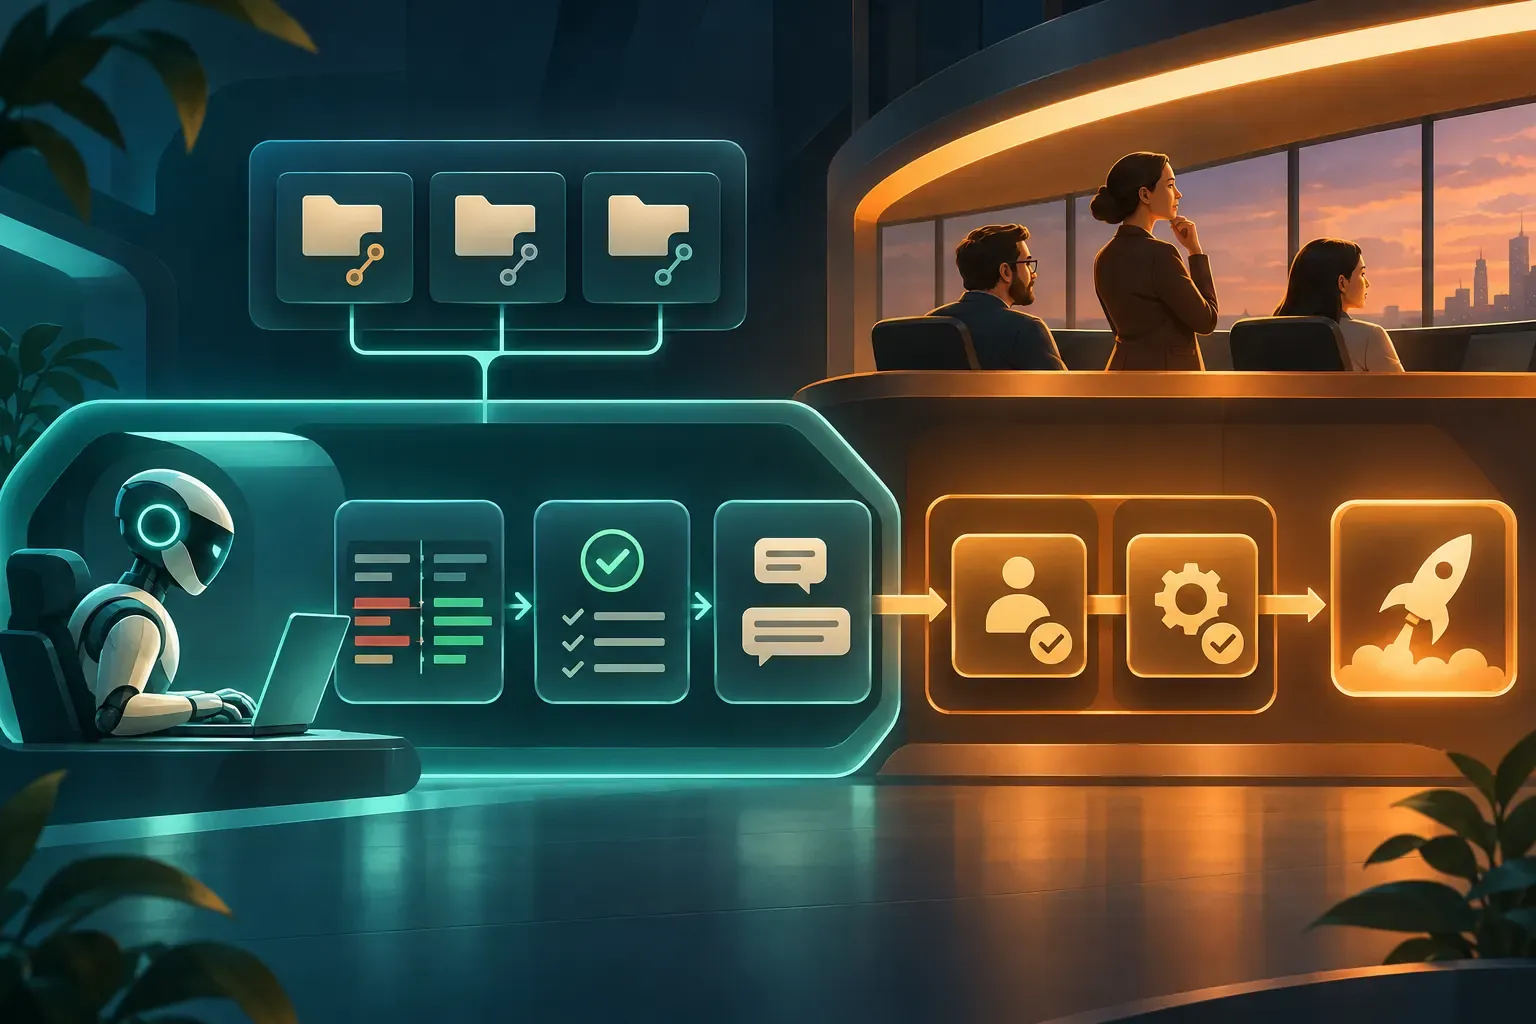
经济高效的多模型软件工程实用指南
如何将强大的推理模型、廉价的编码智能体、独立审阅者和自动验证结合起来——无需为每项任务支付高级模型价格。
真正的问题不是选择最佳的人工智能模型
人工智能的软件开发发生了巨大的变化。 OpenAI Codex、Claude Code 和 Google Antigravity 等工具不再局限于建议单行代码。他们可以检查代码库、设计实现、修改多个文件、执行测试、调查故障以及协调其他智能体。
然而,许多开发人员仍然低效地使用这些强大的系统。
典型的工作流程如下所示:
- 从一个便宜的模型开始来实现一个功能。
- 遇到难题,切换到能力更强的模型。
- 切换回廉价模型进行后续实现。
- 再次切换至高级模型进行审核。
- 返回原始模型以修复审核结果。
- 重复此操作,直到该功能显示完成。
这种方法在经济上似乎是明智的:尽可能使用便宜的模型,并为困难的问题保留昂贵的模型。
但它有隐性成本。
在长时间的编码会话中切换模型可能会破坏提示缓存的重用。不同的模型可能必须处理同一历史的大部分。智能体可能会重复存储库探索,重建早期决策,或者丢失先前交换中隐藏的重要假设。
而且,最昂贵的开发失败并不一定是由于选择了便宜的模型造成的。它们通常是由不明确的需求、不充分的验证或使用相同的推理过程来实施和验证解决方案造成的。
更好的策略是停止将模型选择视为一系列手动开关,并开始将其视为工程编排问题。
中心原则很简单:
使用强大的模型来做出相应的决策,使用廉价的模型来执行有限的工作,使用独立的模型来挑战关键假设,并使用确定性工具来建立正确性。
本文解释了如何在实践中实施该方法。
1. 为什么模型切换有隐性成本
考虑一个包含 80,000 个累积上下文token的开发会话:架构讨论、存储库探索、实现历史记录、失败的测试和调试观察。
开发人员从模型 A 开始,遇到困难问题切换到模型 B,然后返回模型 A。
可能会出现三种开销。
1.1 提示缓存中断
提示缓存通过重用先前处理的、未更改的输入前缀,使重复请求的成本降低。
然而,提示缓存通常与模型和提供者的缓存机制相关联。
Claude Code 的文档明确指出,切换模型会导致新模型上的第一个请求读取对话,而不会从先前模型的缓存中受益。
OpenAI 类似地记录了可重用提示前缀的缓存。
这并不意味着每次模型切换都会产生整个历史的全部成本。实际开销取决于上下文的构建方式、特定于提供者的缓存规则、压缩以及对目标模型的先前请求。
然而,重复切换会大大降低缓存的经济价值。
1.2 重复上下文重构
新模型通常需要理解另一个模型已经做出的决策。
它可能会重新读取架构、检查相同的文件、重建失败的执行路径或重复之前建立的假设。
这不仅仅是一个代币成本问题。它还会增加延迟并带来不一致推理的机会。
1.3 累积的对话噪声
长时间的开发对话包含有用的决策以及过时的假设、失败的方法、工具输出和不相关的细节。
随着对话的增长,模型必须确定哪些信息仍然具有权威性。
正确的解决方案并不总是提供更大的上下文窗口。
通常,它是为了提供更小、结构更好的任务。
替代方案:通过明确交接保持智能体稳定
不要在一次对话中反复更改模型,而是将不同的模型分配给不同的智能体,每个智能体都有自己的上下文和职责。
例如:
- 规划智能体设计架构。
- 实施智能体编写代码。
- 测试智能体执行验收检查。
- 审查智能体独立评估实施情况。
- 协调智能体管理移交和升级。
每个智能体仅接收其分配所需的信息。
结果是更可预测的上下文使用和更清晰的责任边界。
目标是在智能体之间移动工作,而不是在模型之间重复移动一次对话。
2.模型选择应该是基于风险的决策
一个常见的假设是最强的模型应该处理最困难的任务。
这只是部分正确。
难度很重要,但失败的后果和检查结果的难易程度也很重要。
考虑三个开发任务:
任务 A:为 Python 实用程序生成文档。
任务很简单,结果很容易检查,并且错误相对较少。
轻量级模型通常就足够了。
任务 B:实现复杂的市场机制检测算法。
这项任务需要统计理解、仔细的时间序列处理以及对市场假设的解释。
强大的模型在设计过程中可能很有价值,而一旦规范精确,可以将实施委托给中等成本的模型。
任务C:修改自动交易系统的订单重试机制。
代码更改可能只涉及几行,但错误可能会提交重复的订单或绕过风险限制。
即使该任务表面上的编程复杂性很低,也值得仔细设计、独立审查和严格测试。
重要的区别是:
任务复杂度决定了需要多少推理。失败后果决定了需要多少保证。
实用的模型分配矩阵
| 工程活动 | 推荐等级 | 基本原理 |
|---|---|---|
| 要求和架构 | 强 | 糟糕的决策会导致昂贵的下游返工 |
| 任务分解 | 中等 | 需要连贯的规划,但通常不太深入的推理 |
| 代码库探索 | 经济型 | 主要是检索和总结 |
| 例程实现 | 经济型 | 明确指定的任务更容易验证 |
| 复杂算法设计 | 强 | 数学和概念推理占主导地位 |
| 标准调试 | 经济 → 中等 | 从证据驱动的诊断开始 |
| 调试困难 | 强 | 故障机制不清楚时升级 |
| 测试生成 | 经济型 | 用于生成候选测试 |
| 独立严格审查 | 强 | 需要具有挑战性的假设并检测细微缺陷 |
| 文档 | 经济型 | 易于检查和纠正 |
| 发布验证 | 强+确定性 | 判断与可执行证据相结合 |
这些作业是起始假设,而不是通用模型排名。最终应该使用实际存储库中的测量结果来调整它们。
3.架构:强大的规划者和专业的工人
一个有效的多模型开发系统不需要数十个智能体。
对于大多数个人开发人员来说,五个功能角色就足够了:
规划者
规划者负责理解问题并确定技术方向。
其职责包括定义需求、选择架构、识别依赖关系、指定接口和建立验收标准。
强大的推理模型在这里特别有价值,因为架构错误可能会传播到许多下游任务。
然而,规划者不应该持续监督每一个编码操作。
理想情况下,它在项目启动、重大设计决策、架构变更或未解决的技术问题时变得活跃。
工程协调员
协调员负责管理工作流程,而不是亲自解决每个工程问题。
它跟踪任务状态,分配实施工作,收集证据,应用升级规则,并确定任务何时准备好接受审查。
中等能力的模型通常就足够了。
一个重要的成本优化是避免使用最昂贵的模型作为始终活跃的协调器。
实施者
实施者根据批准的规范编写生产代码。
其职责有意缩小:进行所请求的更改、编写相关测试、运行所需的检查并报告结果。
当需求明确且任务受到适当限制时,经济模型可以非常有效。
实施者不应该在遇到歧义时默默地重新设计系统。架构变革应该升级。
独立评审员
审核者根据其预期行为检查实施情况,识别缺陷,挑战假设并评估缺失的测试。
对于高风险的变更,评审者在逻辑上应该独立于实施过程。
使用不同的模型系列可以提供有用的多样性,尽管仅通过更换供应商并不能保证独立性。
审阅者的主要职责是发现正确性问题,而不是产生赞扬或提出外观改进。
验证系统
验证不应完全委托给大语言模型。
编译器、类型检查器、静态分析器、单元测试、集成测试、基于属性的测试和特定领域的模拟提供了更强的可重复证据。
验证系统应该生成其他智能体可以检查的工件。
在定量交易系统中,这包括回测、前瞻评估、经纪商模拟和风险限制检查。
完整的工作流程
一个实用的顺序是:
需求→架构→任务分解→实施→测试→独立审查→纠正→回归测试→最终验证→人工发布批准
并非每个任务都需要每个阶段。
文档更新可能只需要实施和快速检查。实时交易执行的变化需要更多的保证。
这是风险自适应编排的基础。
4. 为什么强规划器不应该持续运行
让一个高级模型负责整个工作流程并让它管理每个从属操作是很诱人的。
这可行,但在经济上可能效率低下。
假设规划者开发了一个架构并将其分解为 15 个实施任务。
如果强模型在所有 15 个任务中保持活动状态,它可能会重复处理状态更新、代码差异、工具输出和例行测试结果。
其中大部分信息不需要高级推理。
更高效的架构将**规划与运营协调分开。
强大的规划者会创建一个具有清晰界面和验收标准的计划。
中等成本的协调器处理任务执行。
仅当协调员发现有意义的架构问题、相互冲突的需求或未解决的高影响问题时,才会咨询强大的规划者。
这产生了分层设计:
人类→强计划者→中等协调者→经济工人
独立审查和确定性验证作为额外的质量关卡。
该设计类似于运行良好的工程组织如何分配责任。
高级架构师不需要监督每一行代码。它们的价值在于做出高杠杆决策并解决超出常规实施范围的问题。
同样的原则也适用于人工智能工程。
5. Codex、Claude Code 和反重力支持什么
截至 2026 年 11 月,所有三个环境都提供有意义的多智能体功能,尽管确切的配置和执行模型有所不同。
OpenAI Codex
Codex 支持在单独上下文中运行的专用子智能体。
其自定义智能体配置可以为每个角色指定模型和推理工作。
开发人员可以在以下位置创建特定于项目的智能体定义:
.codex/agents/
或个人智能体人定义如下:
~/.codex/agents/
该配置支持默认子智能体模型、并发智能体线程限制以及特定于角色的指令。
一个重要的限制:自定义 Codex 子智能体继承父智能体的模型提供程序和相关权限。它们不会自动构成多提供商路由器。
因此,当大多数工作发生在 OpenAI 生态系统中时,Codex 是一个很好的起点。
克劳德代码
Claude Code 支持使用 YAML frontmatter 在 Markdown 文件中定义的自定义子智能体。
例如,项目可以在以下位置定义智能体:
.claude/agents/
每个智能体可以指定一个模型系列,例如 Haiku、Sonnet 或 Opus,具体取决于模型可用性和帐户配置。
Claude Code 可以根据智能体的描述来选择智能体,或者用户可以明确请求专门的智能体。
这使得使用一种模型进行例行实施和使用另一种模型进行严格审查变得很方便。
但是,使用网关或 CC Switch 等工具的开发人员必须验证实际的提供商模型映射。
请求 Opus 别名并不能保证网关将请求发送到 Anthropic Opus。
谷歌反重力
Antigravity 支持子智能体、编排和脚本化动态工作流程。
其动态工作流可以将不同的模型层分配给工作流智能体、返回结构化输出并执行可预测的序列,例如代码审查和纠正。
记录的工作流模型层包括 flash_lite、flash 和 pro 等选项,具体取决于帐户可用性。
Antigravity 还支持针对某些委托任务使用隔离的 Git 工作树,这有助于防止多个智能体同时修改同一工作树。
对于想要更强大的规划器来协调更便宜的执行的开发人员来说,它的 Orchestrator 模式和动态工作流程特别有趣。
能力对比
| 能力 | 法典 | 克劳德代码 | 反重力 |
|---|---|---|---|
| 定制专业智能体 | 有 | 有 | 有 |
| 隔离子智能体上下文 | 是 | 是 | 是 |
| 按智能体角色选择模型 | 是 | 是 | 是,在支持的层级内 |
| 任务委托 | 是 | 是 | 是 |
| 独立审核工作流程 | 是 | 是 | 是 |
| 工作流程脚本 | 通过脚本/API | 通过挂钩/SDK/脚本 | 动态工作流程 |
| 多提供商路由 | 需要兼容的外部集成 | 需要兼容的网关/集成 | 依赖于提供商的 |
| 最佳初始使用 | 编码和存储库工作流程 | 编码和专业审查 | 编排实验 |
实际教训是不要选择一个平台作为通用赢家。
使用能够提供可靠实施、易于理解的配置、可接受的配额和可衡量的验证质量的最佳组合的系统。
如果一个更复杂的编排器的开销超过了所委派工作的价值,那么它并不会自动变得更好。
6. 实际设置:Codex 中基于角色的智能体
考虑一个具有三个智能体角色的项目:计划者、实施者和审核者。
最小的 Codex 配置可能如下所示:
.codex/config.toml
model = "gpt-6.1-sol"
model_reasoning_effort = "medium"

[agents]
enabled = true
max_concurrent_threads_per_session = 3
default_subagent_model = "gpt-6-luna"
default_subagent_reasoning_effort = "medium"
这使得中强模型成为主要智能体,同时将大多数委派工作引导至较便宜的模型。
现在定义一个专门的编码智能体。
.codex/agents/implementer.toml
name = "implementer"
description = "Implement bounded coding tasks with tests"
model = "gpt-6-luna"
model_reasoning_effort = "medium"

developer_instructions = """
Implement one approved task at a time.

Follow the task specification and acceptance criteria.
Make minimal changes.
Write or update relevant tests.
Run checks before reporting completion.

Do not silently modify architecture.

Return:
- Changed files
- Test results
- Remaining issues
- Any required escalation
"""
接下来,定义一个更强的审稿人。
.codex/agents/reviewer.toml
name = "reviewer"
description = "Independent correctness and risk reviewer"
model = "gpt-6.1-sol"
model_reasoning_effort = "high"

developer_instructions = """
Perform an independent review of the code diff.

Prioritize:
- Functional correctness
- Concurrency and state management
- Numerical correctness
- Error handling
- Security and execution safety
- Missing regression tests

Do not modify source files.

Return findings with:
- Severity
- File and location
- Failure mechanism
- Supporting evidence
- Suggested correction

Distinguish confirmed defects from possible risks.
"""
这些模型标识符是当前 Codex 文档支持的示例。实际可用性取决于帐户和环境。
协调员现在可以将实施委托给廉价的智能体,并请求使用更强大的智能体进行独立审查。
无需重复更改主要对话的模型。
对于更经济的配置,主协调器可以使用更便宜的模型,仅在必要时调用专用的高推理规划器。
7. 实用设置:克劳德代码中的专业智能体
Claude Code 使用类似的概念,但将自定义智能体定义存储在 Markdown 中。
例如:
.claude/agents/implementer.md
---
name: implementer
description: Implement well-specified coding tasks
model: haiku
---

Implement the approved task.

Do not expand its scope.
Write unit tests.
Run the relevant checks.
Report changed files and verification results.

Escalate unresolved architectural questions.
批判性的审稿人可以使用更强大的模型:
.claude/agents/critical-reviewer.md
---
name: critical-reviewer
description: Review high-risk implementation changes
model: opus
---

Review the code independently.

Focus on correctness, hidden assumptions,
failure handling, race conditions,
and incomplete acceptance criteria.

Do not modify the implementation.

Report actionable defects with evidence.
当智能体的描述与任务匹配时,Claude Code 可以自动委派工作。实施严格的工作流程时,显式调用更具可预测性。
典型的主管指令可能是:
使用实施者智能体实施批准的功能。在请求独立严格审查之前需要通过测试。将调查结果返回实施者进行更正。在回归测试通过之前,请勿声明该功能已完成。
通过第三方网关路由 Claude Code 时,有一点需要注意。
不同的子智能体别名可能会映射到意外的模型。使用可用的路由日志和 Claude Code 的任务检查工具验证已解析的提供程序和模型。
不要假设特定于模型的行为或成本在网关下保持相同。
8. 缺失的部分:通用任务合约
多模型协作的最大改进往往不是更好的编排框架。
这是一个更好的任务界面。
当一个模型将工作委托给另一个模型时,接收智能体不需要重建整个开发对话。
相反,它应该接收一个紧凑的、结构化的任务包。
考虑:
task_id: TRADING-042

objective:
  implement_safe_order_retry

component:
  broker_execution

risk_level: critical

requirements:
  - prevent_duplicate_orders
  - reconcile_broker_state
  - handle_partial_fills
  - respect_position_limits

constraints:
  - no_live_orders
  - preserve_existing_interfaces
  - no_architecture_changes

acceptance_tests:
  - duplicate_submission_test
  - timeout_recovery_test
  - partial_fill_test
  - exposure_limit_test

routing:
  implementer: economical
  reviewer: strong
  max_failed_attempts: 2

release:
  independent_review: required
  paper_trading: required
  human_approval: required
该任务包有多种用途。
它使要求明确。它独立于实施模型来定义成功。它限制了工作范围。它还确定何时必须升级和进行额外验证。
一个有用的存储库结构可能是:
project/
├── AGENTS.md
├── docs/
│   ├── architecture.md
│   ├── engineering-standards.md
│   └── risk-policy.md
├── tasks/
│   └── TRADING-042/
│       ├── spec.yaml
│       ├── plan.md
│       ├── implementation.md
│       ├── tests.json
│       ├── review.md
│       └── validation.md
└── src/
共享文档是事实的来源。
单独的座席对话是临时的工作环境。
这种区别大大减少了对长期对话历史的依赖,并使开发可以在会话、模型和工具之间重现。
9. 升级:不要一直要求廉价模型再试一次
当智能体重复尝试相同的失败解决方案时,廉价优先策略就会变得低效。
实用的升级策略应该区分几种故障类型。
缺少信息: 该模型缺少必要的要求、日志或存储库上下文。
解决方案:提供缺失的证据,而不是立即升级模型。
探索不足: 模型尚未检查相关的执行路径或依赖关系。
解决方案:增加调查工作或委托重点代码库研究。
实现缺陷: 该模型理解了问题,但引入了编码错误。
解决方案:对失败的测试运行有针对性的纠正周期。
推理失败: 该模型有足够的证据,但多次得出错误的诊断。
解决方案:升级到更强大的模型。
架构冲突: 实现揭示了不一致的假设或不兼容的需求。
解决方案:返回到计划器。
对于普通任务,一个有用的启动策略是在升级之前允许进行一到两次基于证据的修复尝试。
对于关键的交易系统变更,当故障涉及被误解的风险不变式、潜在不安全的执行行为或未解决的数学假设时,请立即升级。
目标不是最小化昂贵模型调用的数量。
这是为了最小化获得验证结果的总成本。
集中升级更高效
假设廉价智能体未能实施波动率调整后的期货头寸规模。
不要将整个存储库转移到高级模型,而是提供:
- 相关头寸大小方程
- 合约乘数和报价规格
- 失败的测试用例
- 实现片段
- 预期行为
要求强大的模型进行诊断,最好不允许更改代码。
然后将诊断结果返回给原始实施者。
这比让昂贵的模型重复每个实施步骤更经济。
10. 代码审查:在重要的地方使用额外的容量
独立代码审查是多模型工程最有力的论据之一。
编写代码的模型可能在开发早期采用了错误的假设。
当被要求审查自己的工作时,它可能会重现这些假设。
单独的审查上下文可以从不同的起点检查结果。
然而,仅仅使用不同的模型是不够的。
可靠的审查过程应包括原始规范、验收标准、相关代码和测试结果。
它应该避免过度依赖实施者关于解决方案是正确的声明。
分层审核
第一层由确定性检查组成:格式化、编译、类型检查、linting、依赖性分析和自动化测试。
第二层是轻量级模型审查。它可以识别直接的缺陷、可疑的假设、缺失的测试和集成错误。
第三层是为关键模块或具有重大失败后果的变更保留的强大的独立审查。
这种结构避免了将高级模型容量花费在确定性工具可以更可靠地识别的问题上。
审阅者应该报告精确的失败机制,而不是模糊的担忧。
例如:
薄弱发现:
订单执行逻辑可能存在问题。
强有力的发现:
如果经纪商接受订单但客户端在收到确认之前超时,则重试路径会创建一个新的客户端订单标识符。这可能会导致接受两个订单。通过模拟智能体接受后的确认超时来重现。
第二个发现是可操作的、可验证的,并且与系统风险直接相关。
好的评审提供证据,差的评审只给出意见。
11. 测试和验证必须保持独立
AI 模型对于生成测试很有用,但生成的测试不会自动确定实现满足真实需求。
如果同一个智能体误解了规范,它可能会编写始终实现相同误解的代码和测试。
因此,正确性需要多种形式的证据。
对于普通软件,这些可能包括:
- 单元和集成测试
- 合约测试
- 基于属性的测试
- 静态分析
- 回归测试
- 端到端测试
对于交易软件,额外的特定领域验证至关重要。
回测正确性
验证功能、标签、信号和执行假设是否尊重每个历史时间戳实际可用的信息。
特别注意前瞻偏差、生存偏差、时间戳对齐、预热期以及训练和评估窗口中的意外泄漏。
市场模型验证
交易算法的评估不应仅限于单一历史回测。
根据策略的不同,适当的方法可能包括前瞻性测试、按时间顺序分离的样本外评估、参数敏感性分析、实际交易成本和压力测试。
对于重叠的金融标签,在构建交叉验证折叠时,清除和禁运技术可能是合适的。
执行正确性
回测表现并不能证明实时订单执行是安全的。
经纪商集成需要对拒绝订单、部分成交、重新连接、陈旧账户状态、重复事件和幂等重试行为进行显式测试。
风控正确性
关键风险约束应作为可执行的系统不变量来实施。
示例包括:
- 订单不得超过批准的持仓限制。
- 提交前必须检查最大允许暴露量。
- 重复重试事件不得产生意外的额外仓位。
- 策略不得绕过禁用的交易状态。
- 即使策略智能体保持活动状态,终止开关也必须阻止新命令。
大语言模型可以帮助检查这些控制措施,但它绝不应该是执行这些控制措施的唯一机构。
12. 量化交易示例:实施新策略
考虑一个开发人员正在构建一个事件驱动的交易平台。
该平台使用经济和市场新闻,使用大语言模型提取事件,估计市场状况,生成交易信号,选择策略并执行订单。
开发人员希望添加一个新的突破策略,该策略可以与现有的均值回归策略一起运行。
有一条重要的安全规则:
只有经批准的策略族才可以在互斥分配政策下活跃。
工作流程可以如下进行。
第一阶段:架构
强大的规划模型定义了突破算法、所需的市场数据、激活条件、执行假设和风险约束。
它还指定了策略如何与机制检测器交互以及强制相互排他性的机制。
该计划必须区分战略建议和允许的命令。
即使机制检测器选择突破策略,独立风险引擎也必须批准提议的订单。
第 2 阶段:任务分解
中等模型创建有界工作单元:
信号计算、策略激活、订单准备、经纪商集成、监控和测试。
每个任务都会收到接受标准和显式依赖性。
第三阶段:实施
经济的编码模型实现隔离的组件。
例如,它编写了突破信号的计算和测试。
智能体人不得擅自改变经纪商风控接口或架构。
第 4 阶段:验证
确定性测试确认正常和边缘情况条件下的计算行为。
历史测试检查时间戳对齐和执行假设。
单独的测试可确保互斥策略激活正常工作。
第五阶段:独立审查
强大的审核者会检查策略和集成变更。
它专门研究市场状态更迭是否可以同时激活两个不相容的策略家族。
它还检查系统改变状态后是否可以执行先前策略的挂单。
这是一个缺陷的示例,该缺陷在孤立的策略测试中可能不可见,但在生产中却很危险。
第 6 阶段:操作验证
系统进入纸质交易环境。
评估包括经纪商重新连接、订单延迟、部分履行、意外市场变动和紧急关闭。
只有在获得所需的证据后,人们才能决定该策略是否适合受控实时部署。
此工作流程不保证交易盈利或操作安全。
然而,它确实将软件正确性、统计有效性、执行安全性和资本配置决策分开——这四个问题经常被混为一谈。
13. 更好地定义人工智能开发成本
仅通过代币价格来比较模型会忽略很多工程经济学。
相关目标是预期的总开发成本:
C_{\text{total}} =
C_{\text{inference}} +
C_{\text{coordination}} +
C_{\text{rework}} +
C_{\text{verification}} +
E[L_{\text{escaped defects}}]
这里:
- (C_{\text{inference}}) 是模型使用花费的金额。
- (C_{\text{coordination}}) 包括编排和上下文传输开销。
- (C_{\text{rework}}) 反映了失败的实现和调试尝试。
- (C_{\text{verification}}) 涵盖测试、审查和验证。
E[L_{escaped defects}]表示流程结束后仍未被发现的缺陷所造成的预期损失。
最后一项在财务软件中尤其重要。
产生有缺陷的订单管理代码的廉价模型可能比产生更可靠实现的更强模型具有更高的预期总成本。
相反,使用高级模型来编写例行文档可能几乎没有什么附加价值。
经济上合理的选择取决于质量和失败后果。
预算分配
对于订阅配额有限的开发人员来说,合理的初始工作负载分配可能是:
| 模型层 | 任务共享 | 主要工作 |
|---|---|---|
| 经济型 | 60% | 编码、探索、测试、文档 |
| 中 | 25% | 集成、协调、调试 |
| 强 | 15% | 架构、硬问题、严格审查 |
这些百分比仅供参考,并非科学确定的最佳值。
它们还代表工作的分配,而不是支出或代币。一小部分高级模型任务可能占 API 支出的很大一部分。
根据订阅计划,优化问题还包括使用配额和访问限制,而不仅仅是每个代币的定价。
订阅不应被视为可互换的 API 积分池。外部网关和基于 API 的编排可能会产生单独的费用。
14.衡量工作流程而不是信任模型声誉
公共编码基准提供了有关模型功能的有用证据,但它们并不能完全表征特定的开发环境。
在孤立的软件工程任务上表现良好的模型在处理市场数据、事件驱动架构、数值计算、智能体 API 和长期运行的集成时可能会表现不同。
最好的策略是创建一个小的内部基准。
从实际项目中选择20-30个有代表性的任务。
包括简单的实现、多文件集成、调试、数学推理、代码审查和关键的执行安全场景。
在多种配置下运行类似的任务:
配置A: 仅限经济型。
配置 B: 仅限中型模型。
配置C: 具有强大独立审查的经济实施者。
配置D: 强大的规划者,经济的实施者,独立的审核者。
评估完整的工作流程而不是孤立地评估每个模型。
曲目:
| 公制 | 为何重要 |
|---|---|
| 验收测试通过率 | 功能成功 |
| 总推理成本 | 直接 API 费用 |
| 配额消耗 | 认购效率 |
| 接受结果的时间 | 开发生产力 |
| 返修周期数 | 返工负担 |
| 缺陷检测召回 | 审核有效性 |
| 误报率 | 评论噪音 |
| 人为干预 | 协调负担 |
| 逃逸的严重缺陷 | 剩余工程风险 |
基准测试应包括未向实施机构披露的隐藏测试或潜在缺陷。
对于交易系统,有用的种子缺陷包括错误的合约乘数、时间戳泄漏、非幂等订单重试、部分填充错误和无效的头寸限制。
随着时间的推移,数据可以支持基于预期成本和质量而不是直觉的路由策略。
15.避免对 Orchestrator 进行过度设计
多智能体系统很有吸引力,因为它们类似于人类工程团队。
但每个额外的智能体都会带来协调开销、上下文消耗、潜在的分歧和故障模式。
并非所有任务都能从分解中受益。
五行错误修复不应需要一名规划者、三名实施者、两名审阅者和一名集成经理。
正确的编排级别取决于任务大小和耦合。
对于小型、易于验证的任务,请使用一种具有自动化测试功能的廉价智能体。
对于中等任务,必要时使用一名实施者和一名审阅者。
对于大型项目,使用架构规划、分解、有界实施任务、独立审查和显式集成门。
当工作单元真正独立时,并行性很有价值。
当多个智能体修改共享文件、依赖相同的可变状态或需要频繁同步时,它可能会适得其反。
Git 工作树、定义良好的接口、明确的所有权和隔离的测试环境有助于减少这些问题。
智能体数量不是绩效指标;经过验证的工程产出才是。
16. 实际实施路线图
采用模型感知编排的最有效方法是渐进式。
第一阶段:角色分离
从主要编码智能体和独立审阅者开始。
定义他们的职责并建立共享的验收标准格式。
不要立即自动化每个开发决策。
第2阶段:标准化任务包
创建一致的任务合同,其中包含目标、约束、所需的测试、风险级别和升级策略。
将合约存储在存储库中,而不是依赖于对话内存。
第 3 阶段:添加自动审核门
实施后运行确定性检查。
请求对符合定义的风险标准的变更进行基于模型的审查。
确保关键发现能够进行校正和回归测试。
第 4 阶段:引入协调
添加跟踪任务状态并应用路由规则的工程协调员。
使用廉价或中等成本的模型,除非协调本身需要更深入的推理。
第 5 阶段:根据测量证据进行优化
跟踪模型使用情况、失败的尝试、测试结果、审核质量和工程时间。
使用这些测量值来更新任务路由。
仅当本机子智能体功能成为明显的限制时才引入跨提供商协调器。
第 6 阶段:添加生产级保障措施
对于财务和其他安全关键系统,集成发布批准、环境隔离、审计日志和明确的部署限制。
让凭证和实时交易权限不受不受约束的编码智能体的控制。
模型永远不应该仅仅因为它声明实现已完成就能够绕过强制性的人工发布门。
17. 十大值得遵守的操作规则
1.使用高级推理进行高杠杆决策。 架构、困难的数学推理和关键缺陷分析值得更强大的模型。 2.经济型模型的默认例程实现。 良好的规格使低成本模型更有用。 3.在可行的情况下保持模型会话稳定。 委托有限的工作,而不是重复切换一个长对话。 4.给每个编码任务明确的验收标准。 模糊的指令使得实现和验证都更加昂贵。 5.E 升级特定的未解决问题。 当失败的公式或执行跟踪足够时,不要传输整个存储库。 6.将实施与独立审查分开。 避免完全依赖原始编码智能体的假设。 7.在高级审核之前使用确定性检查。 编译器和测试更适合许多机械正确性问题。 8.使验证与风险成正比。 订单执行的更改比格式更改更值得仔细审查。 9.跟踪总工程成本,而不仅仅是代币。 返工、协调和逃逸缺陷很重要。 10.在您自己的任务中测量模型性能。 基准和模型声誉是决策的输入,不能替代证据。
结论:从模型切换到工程编排
人工智能辅助软件开发的发展不仅仅是寻找单一最有能力的编码模型的竞争。
这是从与一个模型交互到设计专门的人工智能工作者的可靠系统的转变。
强大的模型可能是最好的架构师,但却是重复变更的不经济的实施者。
轻量级模型可能可以有效地执行明确指定的任务,但不足以调查微妙的财务计算错误。
单独的审阅者可能会发现重要的问题,但它不能取代确定性验证。
协调器可以简化工作流程,但前提是其协调成本与其创造的价值相匹配。
因此,最有效的工程系统有意地结合了这些功能。
的目标不是尽可能经常使用最便宜的模型,也不是到处使用最强的模型。就是使用最便宜的工作流程,能够提供所需级别的验证正确性。
对于构建量化交易系统的开发人员来说,这一原则不仅仅是一种优化。
它成为风险管理架构本身的一部分。
人工智能软件工程的未来不是无休止的模型切换。
它是有纪律的、可衡量的、具有风险意识的编排。
延伸阅读
参考文献
- OpenAI — Codex Subagents。自定义智能体、模型分配、并发和委托。
- Anthropic — Claude Code Subagents。专业智能体、模型选择、上下文隔离和智能体权限。
- Google — Antigravity Dynamic Workflows。脚本化工作流程、结构化智能体输出和模型层路由。
- Google — Antigravity Subagents。智能体委托、隔离执行和多智能体功能。
- OpenAI — Prompt Caching。提示前缀重用和缓存行为。
- OpenAI — Agents API Multi-Agent Guide。多智能体委托和协调。
- OpenAI — Multi-Agent Responses API。上下文分离、并行执行和限制。
- OpenAI — API Pricing。模型定价和缓存输入率。
- 本文中的配置和模型分配是实用的起点。产品功能、模型可用性、订阅限制和 API 定价可能会发生变化。在部署自动化开发工作流程之前验证适用的版本和权限。*