AI 心理健康前沿——多模态精神状态评估需要人的误差回路
一项新的多模态精神状态评估研究提醒开发者:真正需要产品化的不是一个总诊断分数,而是可供临床人员复核的分域误差回路。

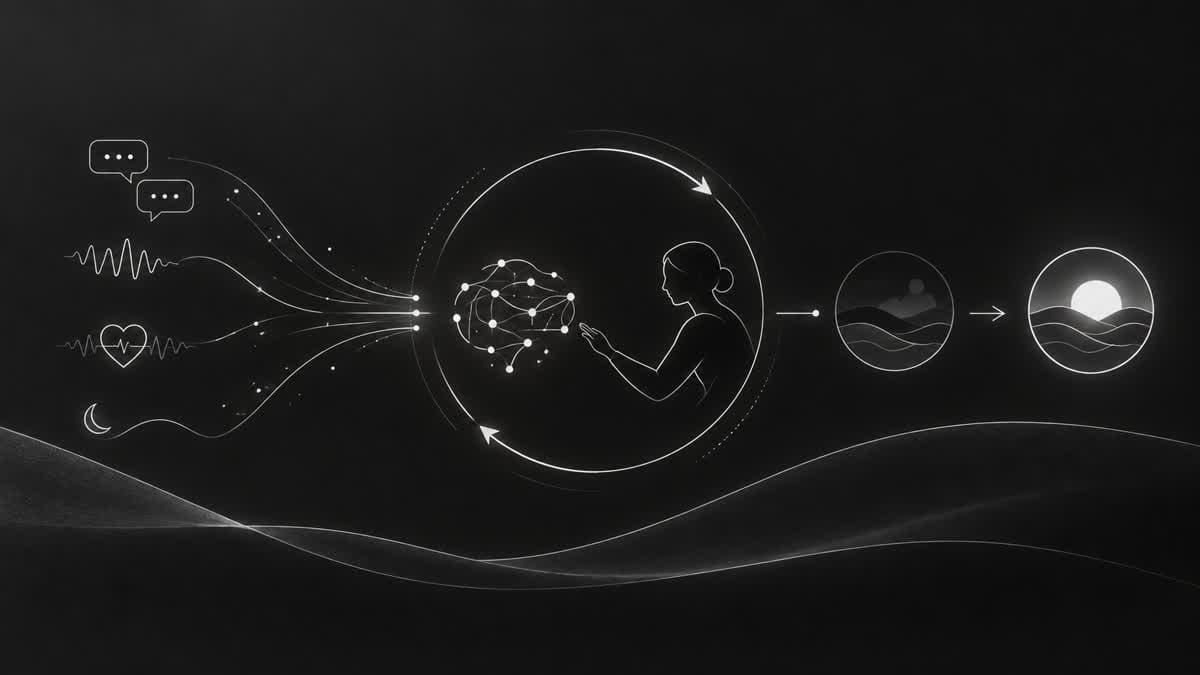
一项发表于 npj Mental Health Research 的新研究,把多模态人工智能系统与精神科团队放在同一项精神状态检查任务中比较。最容易传播的结论是:系统的总体诊断表现接近人类团队。但对开发者更重要的结论是,模型在不同评估维度上的表现并不均衡。产品问题因此不应只是“模型能不能诊断”,而应是“临床人员能不能看见、质疑并利用每一种重要错误”。
前沿信号
来自 UTHealth Houston 与 Yale 的研究团队使用以 Qwen3-Omni 为核心的系统,结合自定义软件分析患者的语音、语调、行为和视频,并生成带有解释的精神状态评估。标准化患者分别呈现不同严重程度的精神分裂症、强迫症和双相情感障碍案例。研究将 AI 与精神科团队在十个维度上进行比较,包括情绪、外表、行为与合作程度、知觉、言语、自杀风险、妄想、强迫观念或行为,以及思维的连贯性和速度。
研究报道显示,系统的总体诊断表现较为稳定,但在外表、精细运动等单项维度上会犯错。作者提出的方向是教学工具和临床辅助,而不是替代精神科医生。
为什么临床与构建者在意
精神状态检查是更大临床流程中的结构化观察层。能够同时处理多种信号的系统,或许能帮助培训中的临床人员,或帮助缺少专科资源的基层医生发现值得进一步核实的线索。它还可能把跨访视的观察整理成可复核的共同记录。
但一个总体标签不足以支持安全使用。临床人员需要知道结论来自语音、行为、观察到的情绪,还是来自录音并未支持的推断。同一个最终诊断,可能隐藏完全不同的失败方式。因此,界面应当呈现分域证据、不确定性、来源和人工修正入口。
这与高风险对话的临床校准测试以及临床校准的精神科初诊质量保证是一致的:临床价值来自对工作流的校准,而不是单一基准分数。
技术解读
该系统把预训练多模态基础模型与定制的软件分析层结合起来,将视频中的观察转换为精神状态评估。研究使用标准化病例,在诊断类别和严重程度可控的条件下,与多中心专家判断进行比较。
对生产系统而言,关键单位不是一个汇总准确率,而是一张矩阵:评估维度、使用人群、录制条件、严重程度和复核者信心。每一个输出都应该保留使用过的证据,区分“观察”与“推断”,并显示临床人员何处不同意。人工修改可以进入质量保证数据集,但不能被简单当作永远正确的标签。
教学场景尤其适合从可检查的错误开始。学员可以把模型的分域判断与专家推理放在一起比较。这样,模型就不只是输出答案的黑箱,而是一个边界清楚的第二阅读者。
临床现实校验
标准化患者视频并不等于日常照护。真实录音会受到光线、音质、语言、文化、残障、药物影响、隐私条件和患者是否愿意面对镜头等因素影响。行为信号也高度依赖情境;模型可能把录制条件或文化差异误判为临床证据。
总体结果不能证明系统适合无人监督的诊断、危机决策或长期监测。研究包含自杀风险这一评估维度,但基准测试并不是已经验证的危机升级系统。任何部署都应保留临床责任和快速人工覆盖,记录模型版本与证据,并在扩大范围前测试不同人群和不同维度的错误。
构建者要点
- 把复核界面围绕十个评估维度设计,而不是只放一个诊断徽章。
- 保存证据来源:音视频片段、观察特征、模型推断、信心和临床修正。
- 按语言、年龄、残障、照护环境和录制质量评估分域敏感度与分歧。
- 先从教学模式开始,用专家比较和反馈验证系统,再进入临床决策支持。
- 将危机相关输出定位为需要进入已验证人工流程的升级线索,绝不作为自主决定。
链接 / 来源
- Mwangi 等:《Human vs. AI clinical assessment》——多模态精神状态评估研究。
- UTHealth Houston 研究报道——研究背景及教学、临床辅助方向。
- 高风险对话评估必须经过临床校准——相关工作流评估视角。
- 精神科初诊需要临床校准的质量保证——相关质量保证视角。