AI 智能体遇到最后一场考试:工作流证据才是新能力测试
新的智能体评测与前沿实验室项目指向同一个现实:只有在长流程、可核验的工作中持续交付,能力主张才有意义。

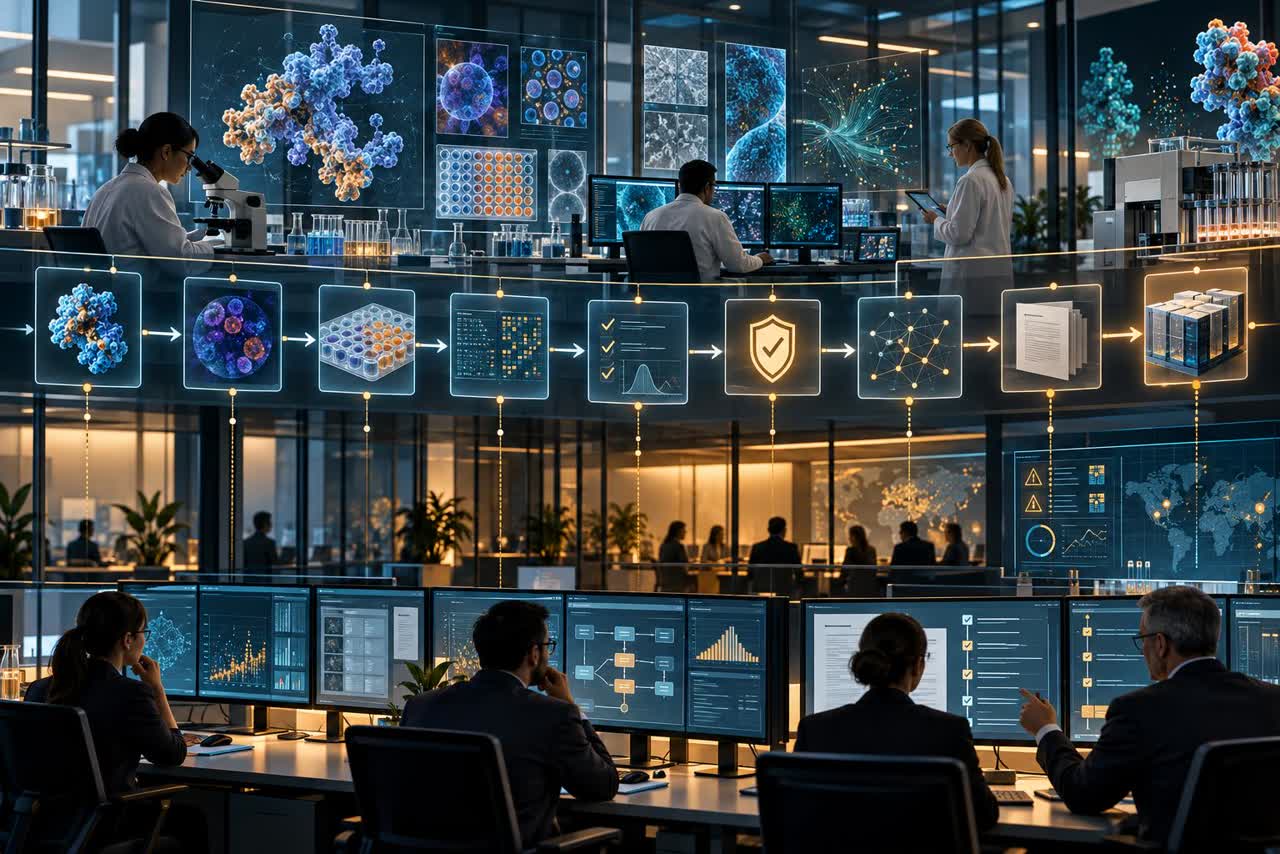
一个智能体可以通过精心准备的演示:调用工具、生成报告、给出看似合理的答案。但真正困难的是,面对目标明确却路径混乱、结果必须核验的工作,它能否把事情做完,并且留下可追溯的证据。
重要的不是 AI 智能体看起来更自主了,而是行业开始把能力主张推向工作流级别的证明;因为基准分数和调用量都不能单独证明可靠工作。
这个变化在本月的两个研究信号中很清楚。论文《Agents’ Last Exam》提出面向长流程、具有经济价值且结果可核验任务的智能体基准,并与 250 多位行业专家合作。另一篇《EvalResearchBench》则追问:智能体能否自己设计评测,降低复杂测试反复运行的成本。产业端,Anthropic 在 10 月 28 日宣布扩展 AI for Science 项目,与 20 个科学机构和研究团队合作。Google DeepMind 的公开研究页面也把模型、科学与责任议题并列呈现,而不是只给出一个“智能体能力”数字。
这些信号并不意味着智能体已经解决了真实工作。它们说明竞争单位正在从一次模型回答,转向一个可负责的工作流。
证据卡:声音与信号
Dario Amodei——组织背景
准确转述,不是个人原话:Anthropic 宣布扩展 AI for Science 合作。日期/场合:2026 年 10 月 28 日,Anthropic 新闻页。主张/机制:把模型接入科学工作流有望产生研究杠杆,但机制仍依赖专家复核和可量化结果。证据等级:A(公司声明):https://www.anthropic.com/news
Demis Hassabis——组织背景
准确转述,不是个人原话:Google DeepMind 10 月的研究页面把前沿模型与科学、责任工作并列呈现。日期/场合:2026 年 10 月,Google DeepMind 研究博客。主张/机制:能力项目正被放进应用与责任层共同构成的系统里,但页面本身不能证明任务表现。证据等级:A(组织研究页):https://deepmind.google/blog/
Yejin Choi——学术通道背景
准确转述,不是个人原话,也不是作者归属判断:近期智能体评测研究把长流程、可核验结果设为测量目标。日期/场合:2026 年 10 月,arXiv 论文《Agents’ Last Exam》与《EvalResearchBench》。主张/机制:以结果为中心的评测能揭示短演示隐藏的失败,而智能体自己生成的测试仍需留出任务审查。证据等级:A(一手论文):https://arxiv.org/abs/2606.05405 与 https://arxiv.org/abs/2610.04184
基准正在靠近真实工作
《Agents’ Last Exam》的设计修正了普通演示的缺陷:任务要足够长、具有经济意义,并且最终结果可以验证。原因很直接:短答案看起来正确,却可能隐藏未完成的计划、没有记录的副作用,或被人悄悄修正过的错误。它是重要的学术一手来源,但提出基准并不等于证明生产可靠性;它首先是一套更好的测量提案。
《EvalResearchBench》把问题再推进一步。它研究智能体能否帮助设计递归自我改进所需的评测。潜在机制很有吸引力:如果评测是瓶颈,智能体或许能降低创建测试的成本。但限制同样明显:智能体写出一份像样的评分标准,并不代表它理解了正确目标,或没有把容易测量的行为当成真正价值。自动生成评测必须经过专家复核、对抗测试和留出任务验证。
两篇论文在方向上相同,在捷径上不同:更好的评测是必要条件,但由智能体自己写出的评测并不会自动可信。
实验室给出方向,却没有给出结论
Anthropic 关于 20 个 AI for Science 合作方的公告,是一个明确的部署信号:机构正在尝试把模型接入研究工作流。但它没有证明这些系统发现了更好的科学结果、缩短了周期,或不再需要专家介入。这是组织层面的投入声明,不是 roster 中某位高管的个人立场。因此它能证明方向与资源投入,不能证明结果。Anthropic 新闻页 是一手来源。
Google DeepMind 的公开研究页也呈现出类似结构:前沿模型与科学、责任议题同时出现。这是有用背景,却不能建立比较能力。更强的证据仍然是任务级评测、可复现基线,以及部署后真实发生了什么的日志。Google DeepMind 研究更新 提供了原始背景。
这里的分歧主要是预测与测量问题,而不是人格冲突。实验室有展示广度和进展的激励;基准作者则有暴露失败模式的激励。就“需要工作流级测试”这一狭窄命题而言,基准一方证据更强,因为它定义了任务和结果。尚未解决的问题是:通过这些考试,是否真的能预测不同组织中的持续价值。
首席数据科学家复核
可观察变量包括任务是否完成、结果是否有效、恢复行为、人工介入、延迟、成本。说“智能体完成了任务”并不是价值的因果解释。团队应在同一时间窗口比较熟练人工、脚本化流程和更简单模型,否则被选择的任务会偏向智能体本来就擅长的场景,而失败运行也可能因报告偏差被隐藏。
未来 30–90 天,给一个工作流加上不可变任务 ID、动作日志、审批节点、返工时间和结果标签。至少追踪三项指标:核验完成率、每个任务的人工修正分钟数、每个被接受结果的成本。成功门槛可以设为:被接受结果提升 10%,额外成本不超过 20%。若严重错误增加、修正时间超过人工基线,或指标只是因为挑选了低价值任务而上升,就停止或重做实验。
这会改变整条链路:数据团队要收集结果标签,而非只看交互量;模型团队要准备留出和对抗任务;产品团队要设计可恢复状态与审批边界;运营团队要统计事故和返工;治理团队要保留跨模型版本仍可追溯的审计记录。智能体控制平面分析 与 测试系统瓶颈分析 解释了为什么这些控制正在变成产品基础设施。
观察指标:未来 30–90 天
观察指标(未来 30–90 天):独立团队能否在新架构上复现《Agents’ Last Exam》;智能体生成的评测能否通过专家与留出任务审查;Anthropic 的科学合作是否发布可量化成果,而不只是合作名单。这些指标能在未来一到三个季度检验或推翻本文判断。
成功阈值:被接受结果提升 10%,额外成本不超过 20%。停止/修订条件:严重错误增加、修正时间超过人工基线,或指标只是因为挑选了低价值任务而上升。
具体行动:给智能体安排一次考试
具体行动(builder/operator):运营者可以立刻选择一个昂贵工作流,冻结一份有代表性的任务样本,在测试前定义“被接受的结果”,再让智能体与现有流程并行四周。不要问它是否令人印象深刻,而要问:它是否以企业愿意支付的成本,产出更多可核验工作,同时减少返工。
开头那个场景并没有消失:演示仍然很容易。改变的是决策标准。每一个新智能体都应先参加一场以结果为中心的考试,再获得生产权限。
来源
- Agents’ Last Exam(arXiv,2026 年 10 月)
- EvalResearchBench(arXiv,2026 年 10 月)
- Anthropic 新闻页
- Google DeepMind 研究博客