别数智能体,先找出不确定的决策
从部署实践拆解模型与代码的职责边界,并给出一套可验证的小实验。

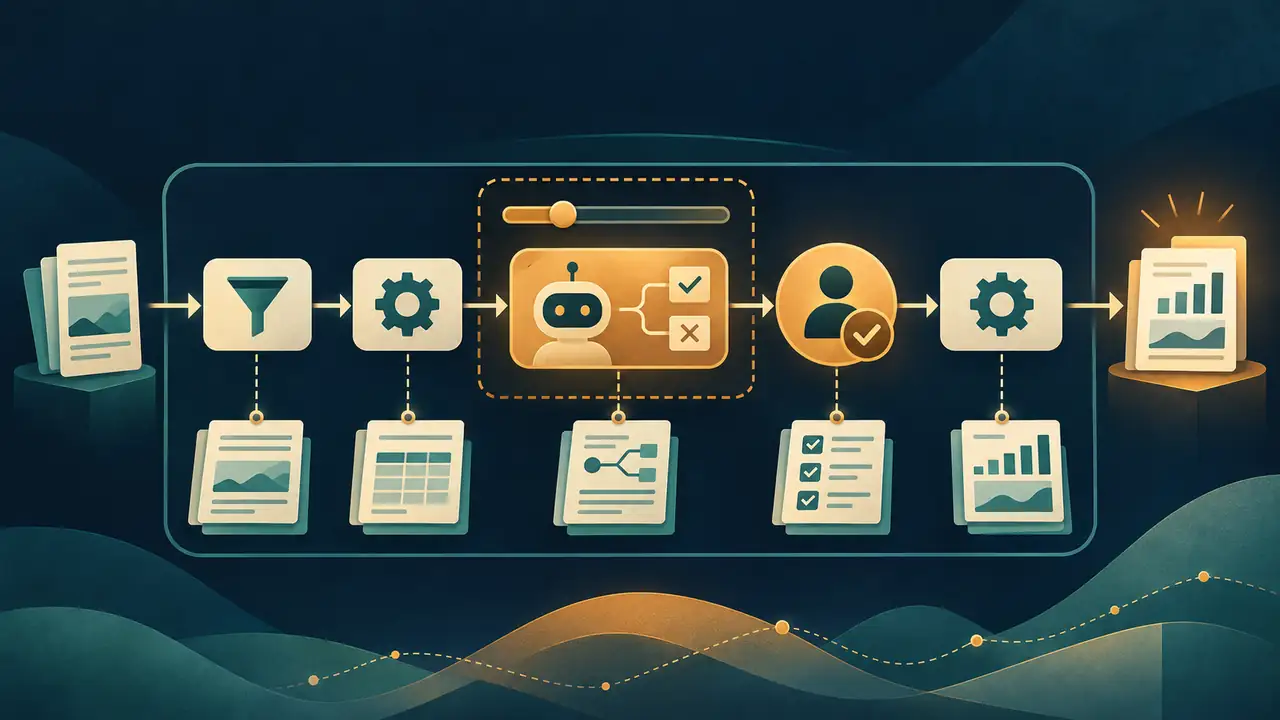
当一个工作流开始不可靠时,“要不要再加一个智能体?”通常不是最好的第一个问题。更有诊断价值的问题是:哪一步无法安全地写成普通、可测试的软件规则? 如果答案是“没有”,增加智能体只是多添一个活动部件,并没有解决瓶颈。如果有一步必须理解不规整的自然语言,或根据人的反馈改变下一步,那它可以成为一个边界清楚的模型决策点;这不等于要把整个流程交给一个自主循环。
这正是 HumanLayer《12 Factor Agents》中值得带走的观点:把智能体看作“在特定决策点使用语言模型的软件”,而不是“一个提示词加上一袋无限工具”。这是作者提出的工程框架和实践报告,不是证明这种架构在所有情况下都更安全、更有效的受控研究。
部署例子展示了边界在哪里
HumanLayer 描述了一个以确定性代码为骨架的部署助手。有人合并变更后,软件先将版本部署到预发环境,再运行端到端测试。随后,一个任务范围很窄的智能体接收指定提交,可以提出生产部署动作。应用程序负责校验工具调用,并请求人工批准;模型本身没有部署权限。在来源报告的例子中,操作人员调整了顺序:“先部署后端。”智能体提出后端动作,系统请求批准,获准后才由确定性代码执行。前端部署沿用同一审批关卡。最后再运行生产测试,决定流程完成,还是需要回滚审查。
关键选择不是“用了一个智能体”,而是解释发生在哪里,决策权又留给了谁 。模型把人的文字修正转换成结构化的下一步动作;代码负责部署顺序、动作校验、暂停等候批准、记录状态和运行测试。来源把它作为真实项目案例来讲,但没有提供不同架构的故障率对照,也没有证明所有部署都该使用智能体。
找到最小但有用的决策边界
在选择智能体框架前,先把自己的工作流画出来,再给每一步标一种性质:
- 规则明确: 输入和正确动作可以被清楚写出。尽可能交给普通代码,例如权限检查、必须运行的测试、固定顺序和重试规则。
- 依赖语言理解: 系统需要解释措辞多变的请求、说明或修正。可以在这里考虑模型,但要把输出限制为少量有类型的动作,例如
deploy_backend、ask_for_clarification或stop。 - 涉及授权: 这一步会改变生产环境、资金、访问权限或其他重要状态。模型可以提出动作;是否执行,仍由确定性策略和有权限的人决定。
接着,给模型步骤定义窄小的动作结构。未知动作或格式错误的参数,要由代码拒绝。“这个提交是否获准?”这类约束也应放在模型决策范围之外。如果提案缺信息或与策略冲突,就返回具体错误或请求澄清;不要让开放式重试循环悄悄编造绕行方案。
这条边界也能告诉你何时不该使用智能体。如果请求都来自稳定表单、规则能覆盖常见情况、例外可以转交人工,确定性工作流往往更简单。如果无法为模型定义受限的动作集合,或者不可逆操作前没有复核机会,设计就还没有准备好增加自主权。
一个真正能做的小实验
以下是待验证假设,不是实验结果: 一个边界清楚的语言决策步骤,或许能处理多种人的修正,同时不让周围的工作流变得更难检查。准备一组固定的代表性请求和修正,既包含明确指令,也包含模糊措辞、未经授权的动作,以及与规定顺序冲突的请求。用同一组案例比较两种实现:一个端到端智能体;以及一条由确定性步骤组成、只在一个决策点调用受限模型的工作流。
保存案例、模型输入与输出、建议动作、校验错误、审批决定、最终状态和人工复核时间。运行前先写清成功条件:未经授权的动作一次也不能执行;模糊或无效请求必须被拦截或澄清;每个结果都能从轨迹中还原;受限版本不能漏掉任务必须完成的内容。只要发生一次越权执行,就应停止实验。如果受限版本并没有更容易审计或运维,这次实验就没有证明增加模型步骤值得。
因此结论应当是有条件的,而不是“智能体越少越好”:可预测的步骤留给软件;只有当你能说清、约束并检查某个语言决策时,才把模型自主权用在那里。先数清这些决策,再数智能体。
实践卡
- 输入: 一个真实工作流、5–10 个代表性案例,以及当前已有的规则。
- 步骤: 画出固定转换;标出语言理解的不确定点;定义有类型的动作;把策略和审批放在模型之外;记录每一次状态转换。
- 产物: 工作流图、动作结构、案例集和可重放的决策轨迹。
- 质量检查: 未授权动作不能执行;模糊之处会显式暴露;每个结果都有可检查的理由。
- 不要据此泛化: 小规模本地练习不能证明生产可靠性,也不能推出普遍适用的智能体数量建议。
来源
- 一手来源:HumanLayer,《12 Factor Agents》
- English companion: Count the Uncertain Decisions, Not the Agents
- 相关站内文章:智能体工作流:先找出最早出错的一步